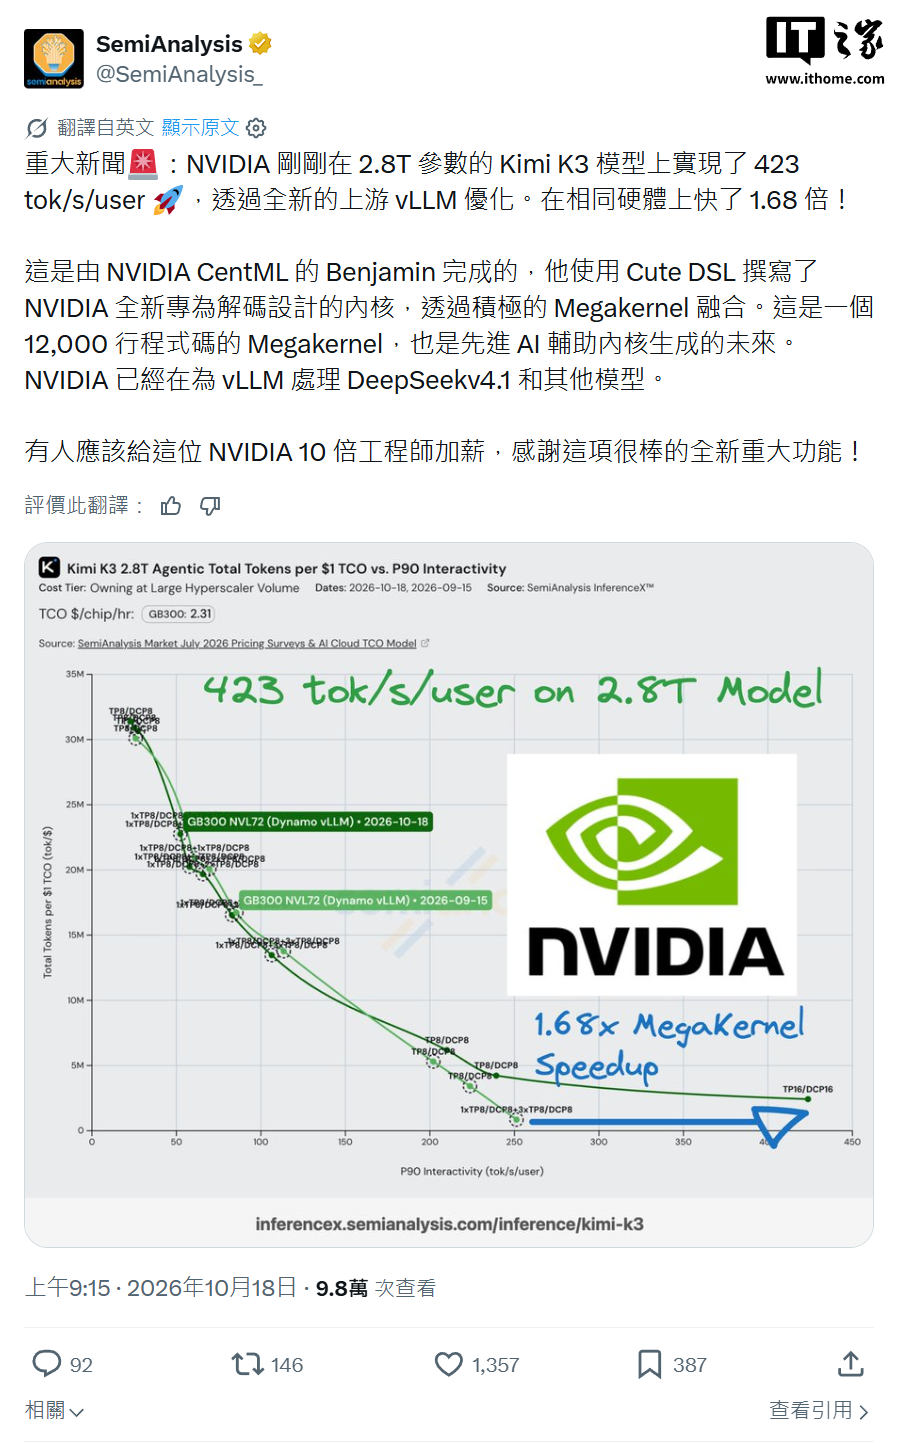
IT之家 10 月 18 日消息,调研机构 SemiAnalysis 今日发文称,英伟达通过一项上游 vLLM 优化,让 2.8 万亿参数量的 Kimi K3 模型实现 423 tok/s/user(每用户每秒每 Token)的推理速度,对比相同硬件(GB300 NVL72)性能提升 1.68 倍。
据介绍,该项优化由英伟达 CentML 工程师 Benjamin 完成。它通过大规模 Megakernel 融合,使用 Cute DSL 编写英伟达新推出的解码专用内核。该 Megakernel 包含 1.2 万行代码,代表着 AI 辅助生成高级计算内核的未来方向。英伟达优化 Kimi K3 模型推理速度,提升 1.68 倍。
IT之家注意到,英伟达除此之外,还在为 vLLM 开发 DeepSeek V4.1 等其他模型的优化。
资深体育分析师
2026年5月15日 回复一手体育资讯,尽在华体会。从热门赛事到小众运动,从赛场内幕到深度数据分析,我们为您一一呈现,满足您对体育的所有好奇。
社区热心用户
2026年5月18日 回复注册华体会体育账号,开启您的专属体育资讯之旅。便捷的注册流程,专业的用户服务,让您轻松获取海量体育资讯。